Как проверить бэкап: тест восстановления за один день, который покажет, спасет ли копия бизнес
Бэкап запускается каждую ночь, отчеты приходят со статусом «успешно», а восстановиться после сбоя все равно может не получиться. Потому что резервная копия — это еще не готовность бизнеса к аварии.
Единственный честный способ это проверить — один раз восстановить критичную систему в изолированной среде и засечь время.
Автор: Авдей Мартынович, руководитель подразделения по работе с СМБ, ALP ITSM
Когда я прихожу к собственнику на первую встречу, вопрос о резервных копиях обычно закрывается быстро:
— Конечно, есть. Админ настроил, копируем каждую ночь.
Тогда я задаю следующий вопрос:
— Когда вы в последний раз восстанавливались из этой копии целиком? Не возвращали один случайно удаленный файл, а поднимали сервер, базу 1С или почту так, чтобы сотрудники могли снова работать?
Чаще всего ответ — «никогда».
И админ не обязательно виноват. Просто ему могли ни разу не поставить задачу убедиться, что из копий можно восстановить рабочий сервис за приемлемое для бизнеса время.
Ниже — простой сценарий: он за один рабочий день дает честный ответ и не затрагивает рабочую инфраструктуру.
Почему «копия есть» — не значит «мы восстановимся»
Чтобы восстановление действительно помогло бизнесу, недостаточно просто иметь файл с копией. Нужно заранее убедиться в нескольких условиях:
- копия должна быть актуальной и целой;
- она не должна храниться на том же сервере или диске, что и рабочие данные;
- должен быть доступ к учетным записям, ключам, паролям и лицензиям;
- нужно понимать порядок запуска зависимых систем;
- восстановленная система должна не просто включиться, а позволить пользователям выполнять рабочие операции;
- восстановление должно уложиться в срок, который бизнес действительно может себе позволить;
- пространство для целевого восстановления должно быть готово, либо должен быть понятный сценарий по его созданию, с конкретными сроками.
Именно здесь обычно обнаруживается разрыв между уверенностью «у нас все копируется» и реальной готовностью к сбою.
Например, компания может восстановить систему расчета зарплаты за несколько часов и выяснить, что пользоваться ею невозможно. За годы доработок она стала зависеть от данных пропускной системы, личных кабинетов сотрудников и нескольких интеграций. Формально сервер поднят. Фактически зарплату посчитать нельзя.
Другой типичный сценарий — резервное копирование месяцами выполняется с ошибками репликации. Бизнес и ИТ получают привычный отчет о выполненном задании.
Но при восстановлении выясняется, что копия неполная, поврежденная или слишком старая для рабочего сценария. Часто это всплывает только во время реального сбоя или, если повезет, во время теста.
Еще одна распространенная ошибка — хранить рабочие данные и резервные копии на одной площадке. При отказе сервера, пожаре, краже оборудования или атаке шифровальщика под угрозой оказывается все сразу.
Отдельный риск связан с кибератаками. Компания может восстановиться после шифровальщика, но не провести расследование причины инцидента. Если злоумышленник сохранил доступ или вредоносный код попал в резервные копии, повторное восстановление вернет проблему вместе с данными. Бэкап здесь возвращает в прошлое. Причину атаки он не устраняет.
Что показывает один день теста
Тест восстановления отвечает не на вопрос «создается ли копия?», а на более важный вопрос: «сможем ли мы снова работать после сбоя?»
За один день можно проверить четыре критичные вещи:
- существует ли пригодная для восстановления копия;
- насколько она свежая;
- сколько времени занимает развертывание — хотя бы грубо, по объемам данных и скорости их передачи;
- можно ли реально работать в восстановленной системе.
Для бизнеса за ними стоят две разные цифры.
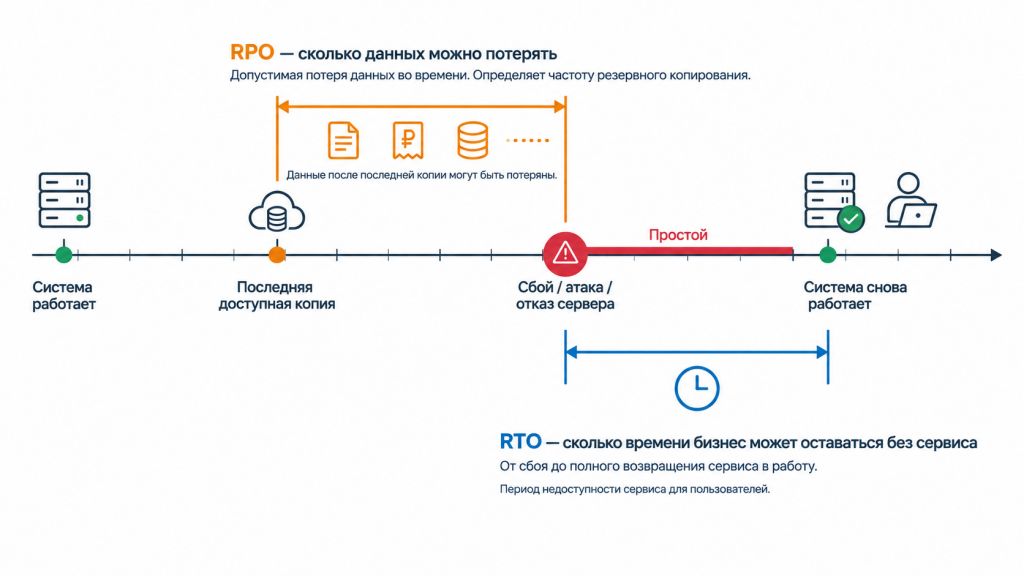
RPO показывает, какой объем данных компания потеряет при аварии. Например, если последняя рабочая копия 1С сделана в 02:00, а сбой произошел в 14:00, могут быть потеряны до 12 часов работы: документы, оплаты, заказы, изменения справочников.
RTO показывает, сколько времени потребуется, чтобы сервис снова стал доступен для работы. Это не время распаковки архива, а интервал от решения «восстанавливаемся» до момента, когда пользователь входит в систему, видит актуальные данные и может выполнять операции.
На экспресс-аудите в розничной сети примерно из сорока точек бизнес был уверен, что 1С вернется в работу за час. ИТ-команда реально могла обеспечить восстановление примерно за четыре часа.
Никто не считал это расхождение проблемой, пока не возник вопрос о проверке. Один тест дал бы компании вместо предположений измеримый факт.
Для критичных систем не существует универсальной «правильной» частоты копирования или единого нормативного срока восстановления. Все зависит от бизнеса.
Если бизнес допускает потерю данных за один рабочий день, ночное резервное копирование может соответствовать его RPO. Но только при условии, что копия действительно создается, хранится отдельно и из нее можно восстановиться.
Если же каждая потерянная операция означает недополученную выручку, ошибку в заказе или кассовый разрыв, копии нужны чаще — например, раз в час или несколько раз в день.
Главное — не ориентироваться на привычное расписание бэкапа. Сначала нужно договориться, сколько данных бизнес готов потерять и сколько времени может работать без конкретной системы. После этого проверять, соответствуют ли этому реальные возможности ИТ.
Тест восстановления за шесть шагов
Тест проводит штатный администратор или ИТ-подрядчик. Роль собственника, руководителя или ответственного сотрудника — поставить понятную задачу и получить измеримый результат.
1. Выберите одну критичную систему
Не пытайтесь за один раз проверить всю инфраструктуру. Выберите сервис, без которого бизнес не сможет нормально работать уже завтра утром.
Чаще всего это:
- 1С;
- почта;
- файловый сервер с договорами, сметами или проектной документацией;
- CRM;
- система учета производства, склада или продаж;
- кассовая или торговая система.
Один тест — одна система. Так результат будет понятным, а задача — выполнимой за день.
2. Возьмите копию из отдельного хранилища
Не используйте копию, которая лежит рядом с рабочими данными.
Резервная копия должна храниться отдельно: на другом сервере, в облаке, на отчуждаемом носителе или в другом дата-центре. Если единственная копия находится на том же диске, что и база 1С или файловый архив, первая проблема уже найдена.
Практический ориентир — правило 3-2-1:
- есть не менее трех копий данных;
- они хранятся как минимум на двух разных типах носителей;
- хотя бы одна копия находится вне основной площадки.
Для защиты от шифровальщиков полезно, чтобы хотя бы одна копия была неизменяемой: ее нельзя удалить или зашифровать из рабочей инфраструктуры обычной учетной записью администратора.
3. Разверните копию отдельно от рабочей среды
Восстанавливать нужно на отдельной виртуальной машине, тестовом сервере или изолированном контуре.
Рабочие системы во время проверки трогать нельзя. Нельзя «восстанавливать поверх» действующей базы или рабочего сервера, даже если кажется, что процедура безопасна.
В изолированной среде можно спокойно проверить процесс и не создать новый инцидент вместо теста.
4. Проверьте не запуск, а работоспособность
Недостаточно увидеть, что архив распаковался или служба запустилась.
Проверьте сценарий, который имитирует обычную работу:
- пользователь входит в систему;
- база 1С открывается;
- документы за последний рабочий день на месте;
- формируется отчет;
- доступны критичные справочники;
- работают необходимые интеграции или понятно, какие из них потребуется поднимать отдельно;
- дата данных соответствует ожидаемой точке восстановления.
Последний пункт особенно важен. Он показывает фактический RPO — объем данных, который будет потерян при аварии.
5. Засеките время
Измеряйте время от команды «начинаем восстановление» до момента, когда в системе можно выполнять рабочие операции.
Это ваш фактический RTO — время, за которое сервис возвращается к работе.
6. Сверьте результат с потребностью бизнеса
Зафиксируйте результат на одной странице:
- дату теста;
- проверяемую систему;
- используемую резервную копию и ее дату;
- фактическое время восстановления;
- объем потерянных данных;
- что не сработало;
- кто выполнял тест;
- какие действия нужно сделать до следующей проверки.
Если восстановление занимает больше времени, чем бизнес может ждать, это не повод искать виноватого. Это конкретный риск, который можно обсудить и устранить.
Что обычно обнаруживает первый тест
Первый тест восстановления редко проходит идеально. Это нормально: его смысл как раз в том, чтобы найти слабые места до аварии.
Чаще всего тест выявляет следующее.
Копия хранится вместе с данными. Например, резервные копии лежат на том же сервере или дисковом массиве, что и рабочая база. Если сервер выйдет из строя или данные зашифрует вирус, пропадут и база, и копии — восстанавливаться будет не из чего.
Копия не создавалась или повреждена. В отчете задание отмечено как выполненное, но файл копии пустой, неполный или не открывается. Узнать об этом можно только при попытке восстановления — и лучше на тесте, чем во время аварии.
Копия слишком старая. Система может восстановиться технически, но компания потеряет больше данных, чем готова потерять. Например, базу 1С копируют раз в сутки, ночью. Если сервер сломается в шесть вечера, из копии вернется состояние на прошлую ночь, а накладные, оплаты и заказы за весь рабочий день придется восстанавливать вручную.
Восстановление длится слишком долго. Бизнес рассчитывает, что 1С или кассы заработают через час, а загрузка копии, запуск и проверка данных занимают несколько часов. Все это время сотрудники не могут отгружать товар и выставлять счета.
Не описаны зависимости и порядок запуска. Каждая система по отдельности поднимается, но друг без друга они не работают, и никто не знает, что запускать первым. Например, 1С из копии запустилась, но не видит сервер лицензий, домен или обмен с банком. Формально система работает, а провести платеж или отгрузку нельзя, пока не поднимут все, от чего она зависит.
Процедуру знает один человек. Восстановить систему может только администратор. Если он в отпуске, на больничном или уволился, команда останется без инструкции, паролей и понимания, с чего начать.
После первого успешного теста одной системы полезно провести второй этап и проверить восстановление не отдельного сервера, а минимального набора сервисов, необходимого для работы бизнеса.
Именно на этом этапе становится видно, в каком порядке нужно поднимать инфраструктуру. В крупной среде это особенно важно: десятки систем нельзя восстанавливать «по алфавиту». Нужны приоритеты и карта зависимостей.
Как часто повторять и кто отвечает
Для критичных систем разумный минимум — тест раз в полугодие. Если инфраструктура часто меняется, появляются новые интеграции, меняется схема авторизации или способ резервного копирования, тестировать стоит чаще.
Проверка годичной давности не гарантирует, что сценарий сработает сейчас. За это время могли измениться:
- серверы и виртуальная инфраструктура;
- версии 1С, СУБД и операционных систем;
- учетные записи и пароли;
- сетевые настройки;
- лицензии;
- интеграции с банками, кассами, CRM и внешними сервисами;
- состав критичных систем.
За тест должен отвечать конкретный человек, а не абстрактное «ИТ»: внутренний администратор, руководитель ИТ, подрядчик или сотрудник со стороны бизнеса, который ставит задачу и принимает результат.
Нужен простой журнал тестов. В нем достаточно фиксировать:
- дату;
- систему;
- дату проверенной копии;
- фактические RPO и RTO;
- найденные проблемы;
- ответственного;
- срок исправления;
- дату повторной проверки.
Через год такой журнал покажет состояние ИТ-инфраструктуры честнее, чем любые заверения о том, что "бэкапы настроены".
Если тест не прошел
Неудачный тест не означает, что нужно немедленно менять систему резервного копирования или заказывать масштабный аудит. Сначала устраните базовые риски.
Начните с четырех действий:
- Организуйте отдельное хранилище для резервных копий, чтобы данные и копии не погибли одновременно.
- Составьте короткий регламент: что копируется, куда, как часто, кто отвечает, какой объем данных бизнес готов потерять и когда проводится тест.
- Опишите последовательность восстановления, зависимости между системами, необходимые доступы и ответственных.
- Повторите тест после изменений, а не ограничивайтесь проверкой настроек в консоли.
Производственная компания примерно на 200 сотрудников после IT Check-up внедрила регламент проверки силами своей команды примерно за два месяца, без аудита. Главное — зафиксировать выявленные проблемы и назначить ответственных.
Внешняя проверка полезна в двух случаях. Первый — вы не уверены, проводился ли тест вообще, и не можете оценить, насколько корректно ИТ описывает состояние инфраструктуры.
Второй — тест провалился, но по его результатам непонятно, в чем причина: в настройках резервного копирования, инфраструктуре, доступах или зависимостях между системами.
В первом случае достаточно IT Check-up: мы проводим интервью с бизнесом и ИТ-специалистами, анализируем ключевые риски и готовим короткий отчет без технического жаргона. Во втором нужен ИТ-аудит с доступом к серверам, логам, системе резервного копирования и настройкам инфраструктуры — чтобы найти корневую причину, а не только зафиксировать симптом.
Проверить до аварии
Резервная копия похожа на мотоциклетный шлем: пока дорога ровная, о нем не вспоминаешь. Но застежку и размер проверяют в гараже, а не в момент падения.
Проверьте одну критичную систему. Восстановите ее отдельно от рабочей среды. Засеките время. Убедитесь, что пользователи могут работать.
Один рабочий день теста скажет о готовности к аварии больше, чем год зеленых галочек в отчетах о резервном копировании.
Хотите понять, насколько ваша ИТ-инфраструктура готова к сбою? На IT Check-up за 3–5 рабочих дней по интервью с вами и ИТ-специалистом выясним, какие риски есть в вашей ИТ-инфраструктуре и с чего начать.